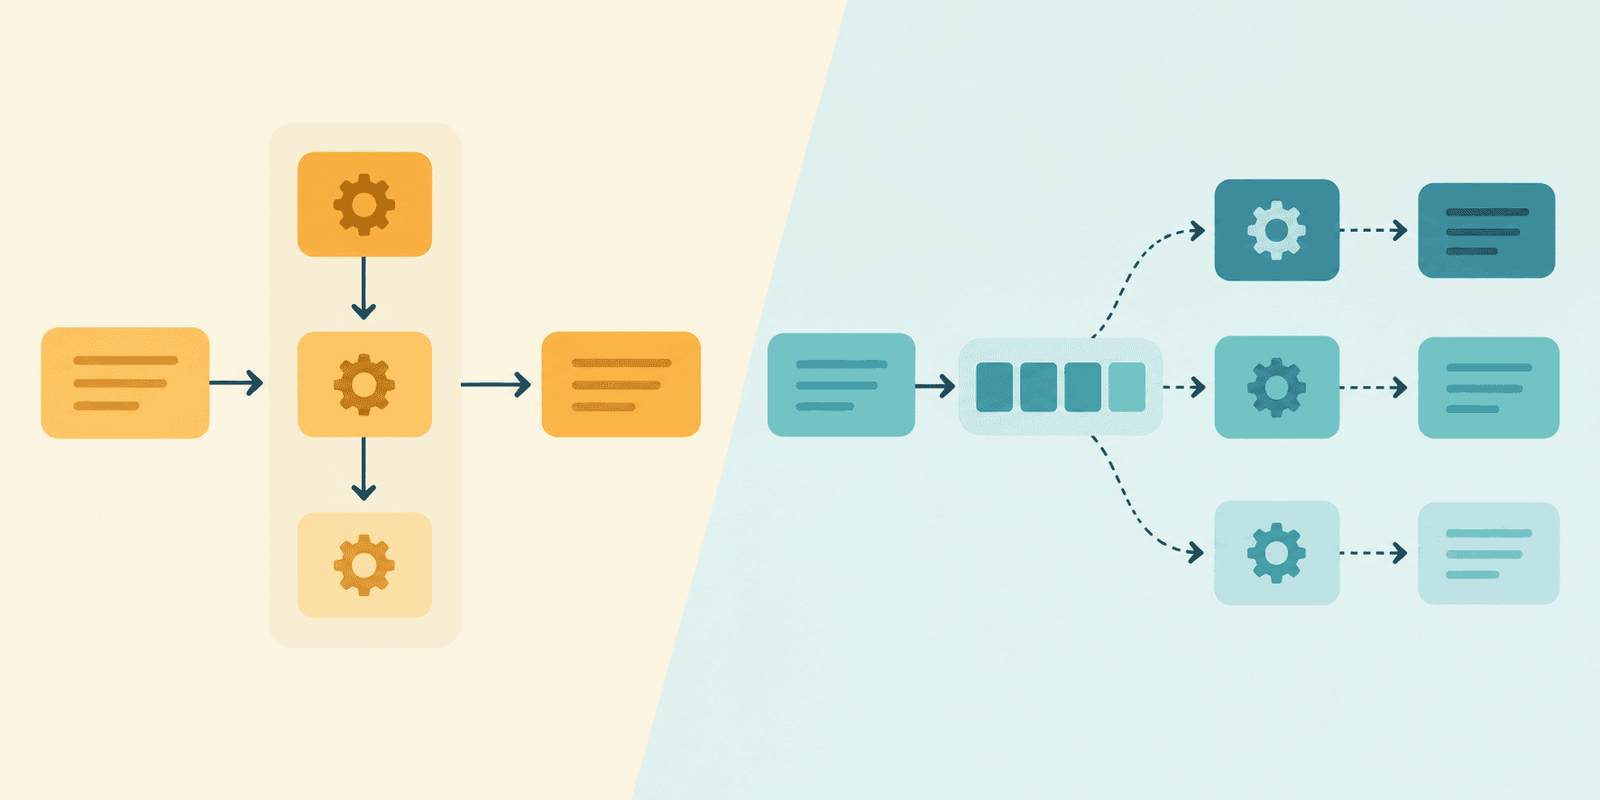

A escolha entre execução síncrona e assíncrona define o sucesso de agentes de IA em produção, impactando diretamente a latência, a experiência do usuário e o custo computacional.
Destaques Rápidos
- Síncrono bloqueia a resposta até que o processamento do LLM termine, ideal para tarefas rápidas.
- Assíncrono usa filas de mensagens para processar tarefas complexas em segundo plano.
- A latência de chamadas de LLM pode ultrapassar 10 segundos, tornando o padrão assíncrono essencial para escalabilidade.
Sistemas síncronos são mais simples de implementar e depurar no início do desenvolvimento. No entanto, quando um dos agentes de IA precisa realizar múltiplas chamadas de API de forma sequencial, o tempo de espera do usuário final aumenta drasticamente. Isso pode prejudicar a experiência de uso em aplicações em tempo real.
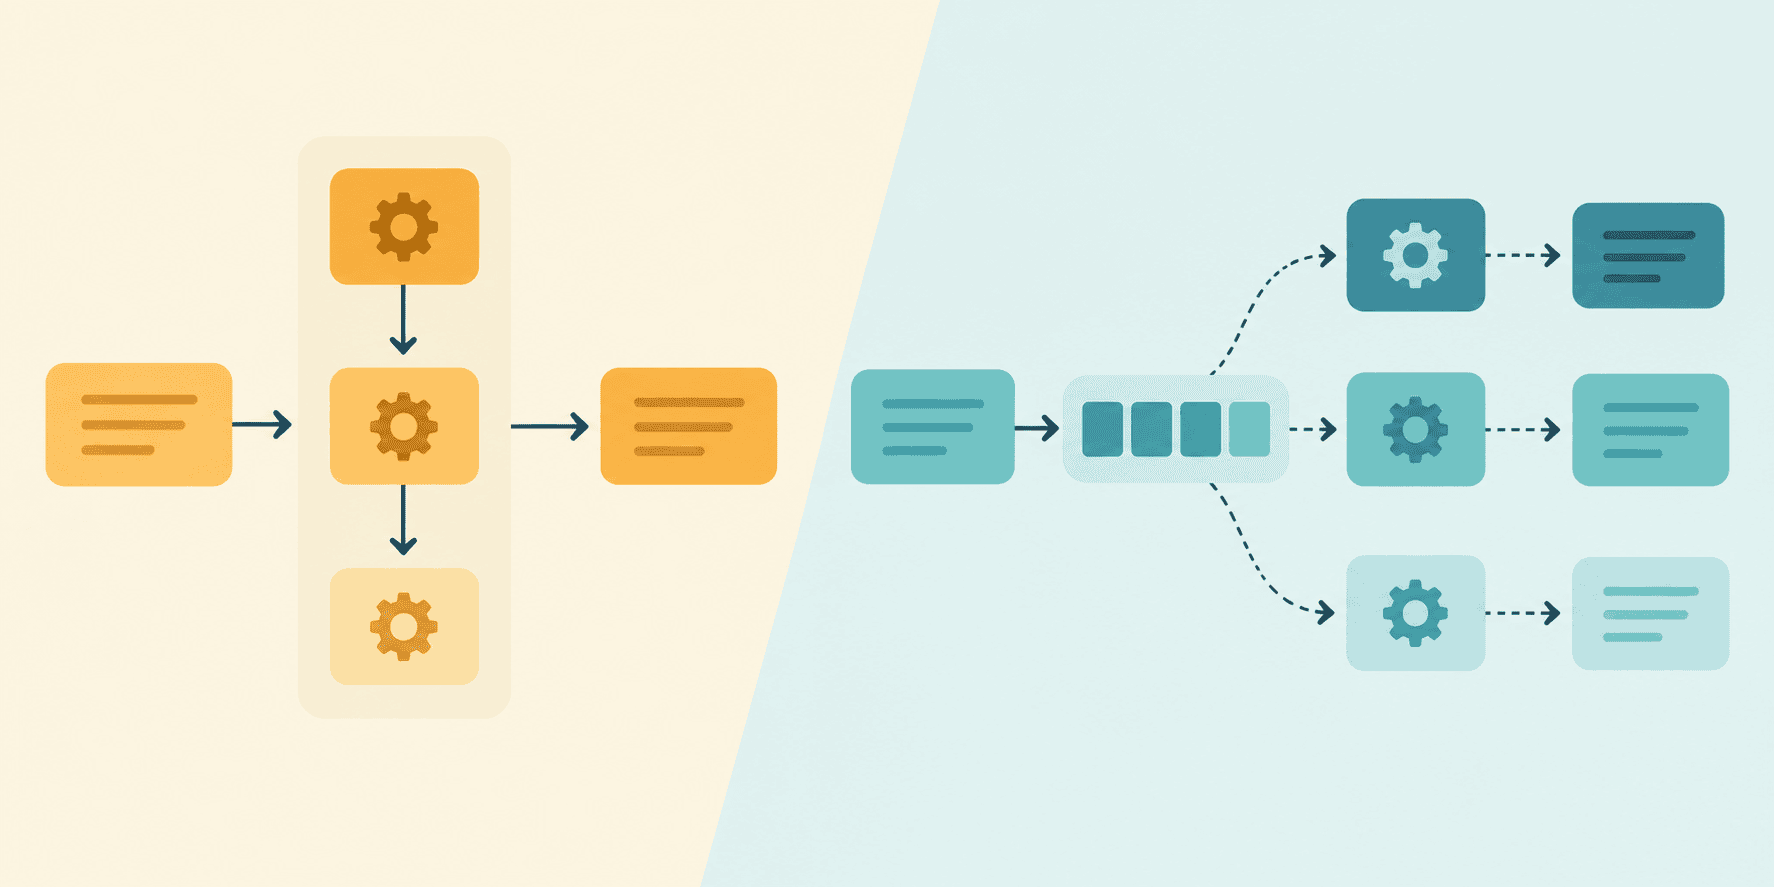
Por outro lado, a arquitetura assíncrona desacopla a requisição inicial do processamento real. O usuário recebe uma confirmação imediata enquanto o trabalho pesado é gerenciado por filas de mensageria. Esse modelo é altamente recomendado para fluxos de trabalho complexos e de longa duração.
Desafios na Arquitetura de Agentes de IA em Produção
Implementar esses sistemas exige atenção especial à tolerância a falhas e ao gerenciamento de estado. Em cenários assíncronos, o uso de ferramentas como WebSockets ou Server-Sent Events torna-se obrigatório para atualizar o cliente sobre o progresso. Além disso, o controle de custos com tokens de LLM deve ser monitorado de perto em ambas as abordagens.
Critérios de Escolha para seu Projeto
Se a sua aplicação exige respostas imediatas e possui fluxos simples, o padrão síncrono é o caminho mais rápido. Contudo, se você planeja escalar agentes de IA para executar tarefas complexas de análise de dados, prefira a arquitetura assíncrona. Ela garante que o sistema permaneça responsivo mesmo sob alta carga de requisições.
Por fim, a combinação híbrida de ambos os padrões tem se provado uma excelente alternativa no mercado atual. Desenvolvedores podem usar chamadas síncronas para interações simples de chat e delegar tarefas demoradas para workers assíncronos. Essa flexibilidade otimiza o uso de recursos de computação em nuvem.
Fonte original: Leia mais na fonte