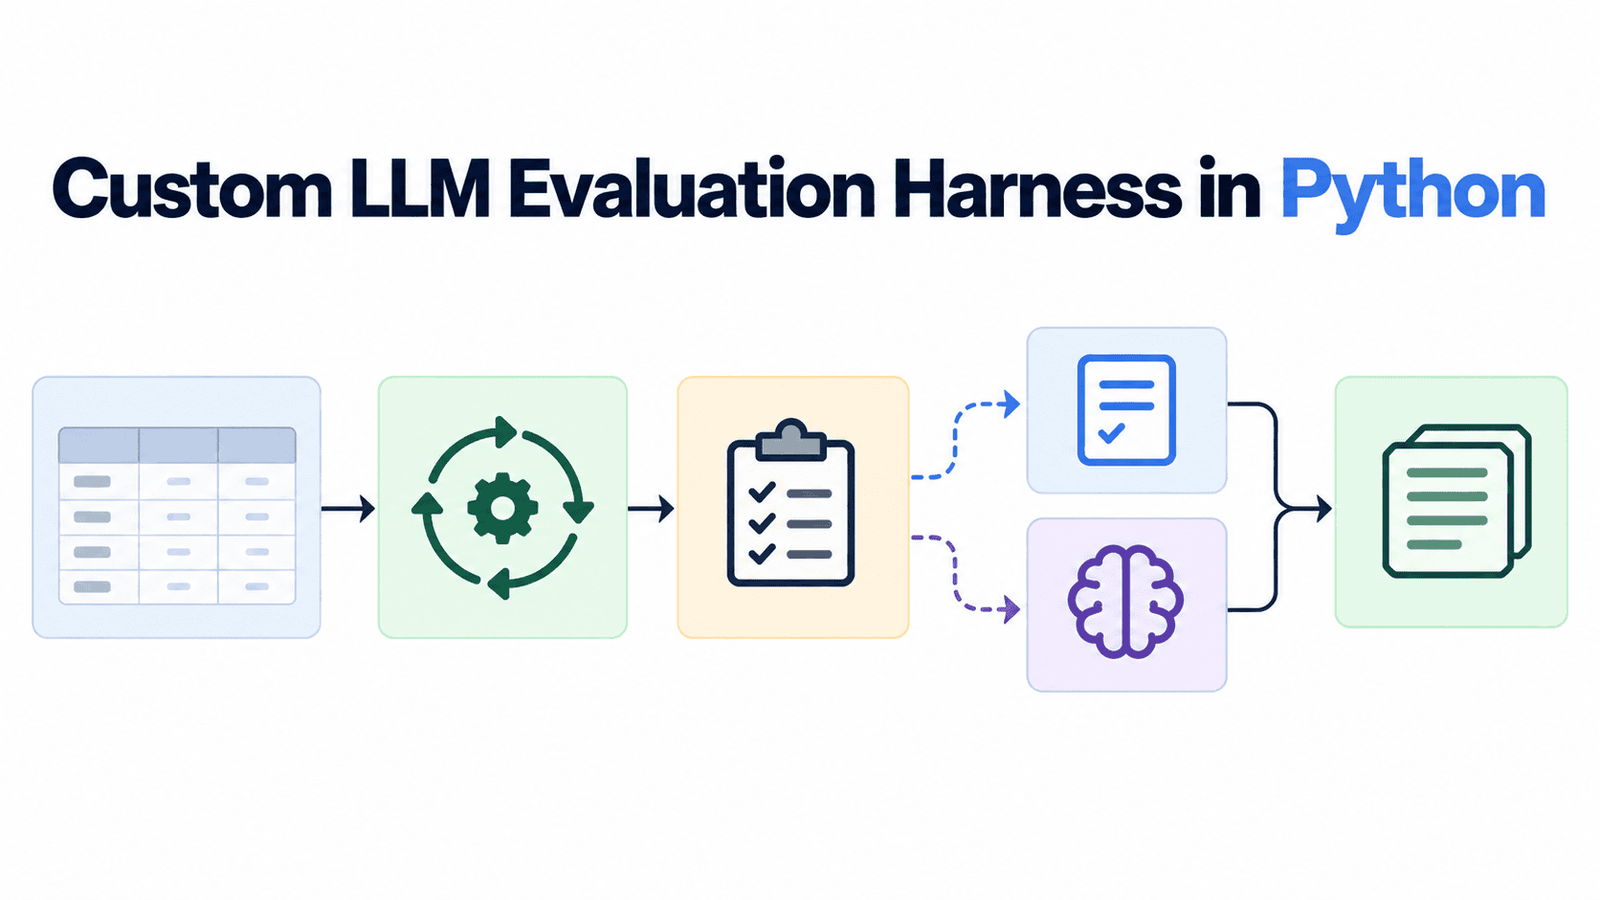

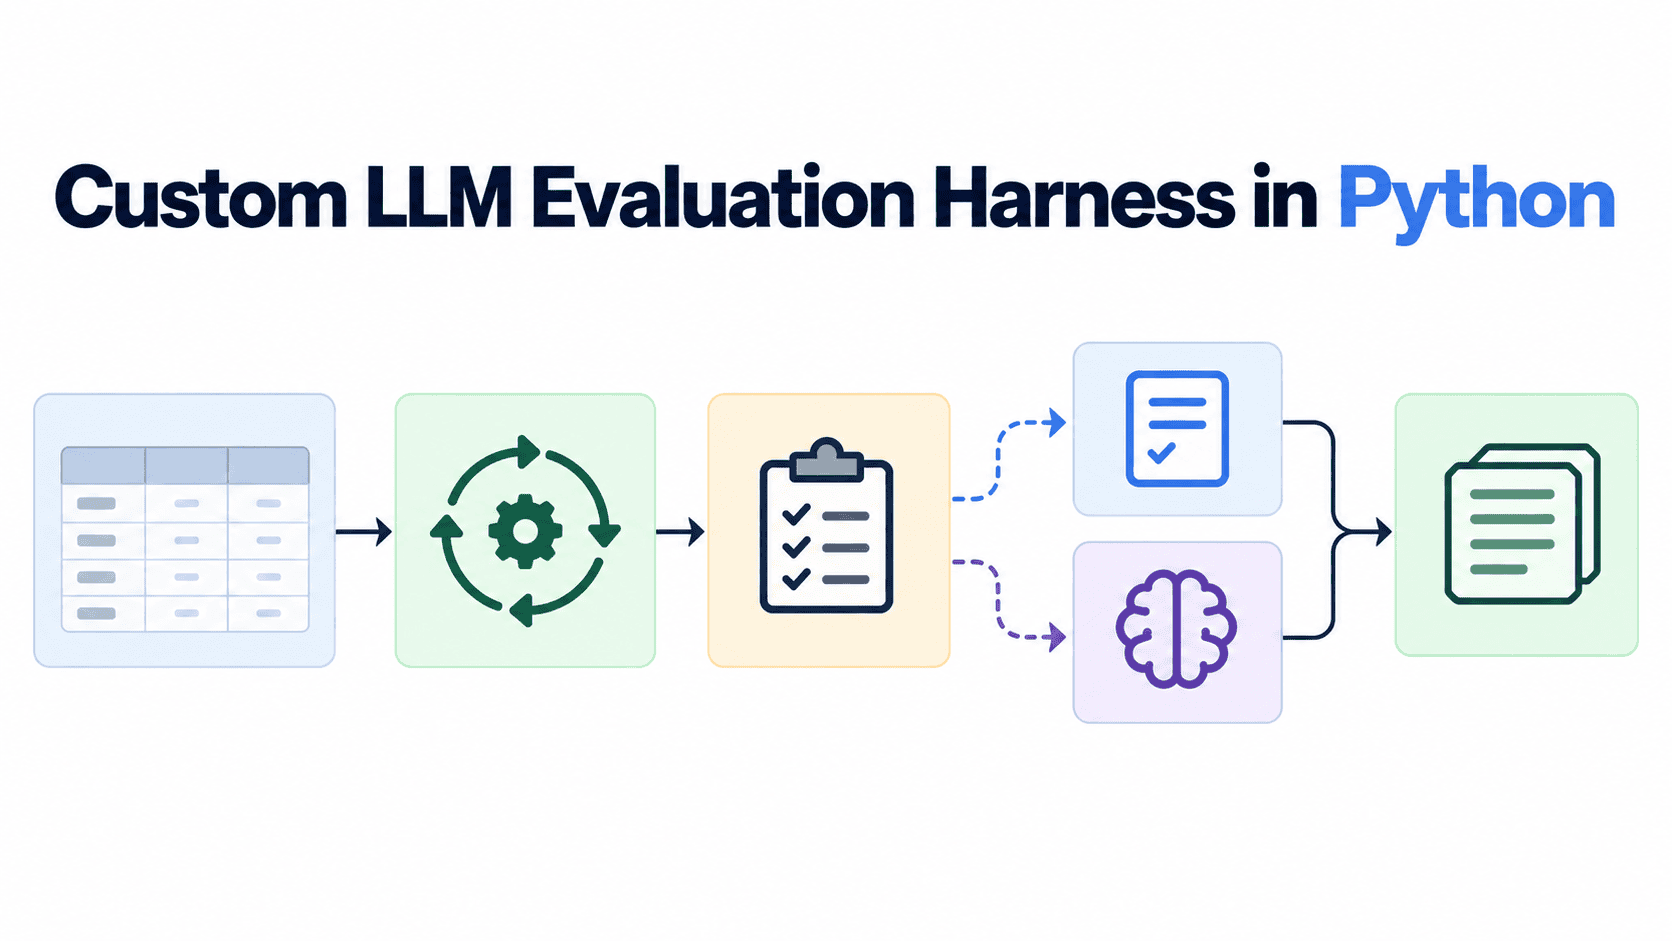
A avaliação de LLMs pode ser personalizada do zero em Python usando quatro componentes modulares essenciais: conjunto de testes, executor de prompts, avaliador de respostas e agregador de métricas, permitindo testes precisos e sob medida.
Destaques Rápidos
- Arquitetura dividida em 4 módulos independentes para facilitar a manutenção e escalabilidade.
- Controle de custos e latência diretamente integrado ao ciclo de vida dos benchmarks.
- Capacidade de testar modelos líderes como GPT-4, Claude 3.5 Sonnet e DeepSeek-V3 com métricas customizadas.
Por que criar um sistema de avaliação de LLMs próprio?
Ferramentas prontas de mercado nem sempre atendem às necessidades específicas de negócios ou domínios técnicos restritos. Desenvolver uma infraestrutura própria oferece total governança sobre as métricas e reduz a dependência de plataformas de terceiros.
Além disso, esse fluxo permite comparar diretamente o desempenho de fornecedores líderes como OpenAI, Anthropic e modelos open-source. Essa abordagem assegura que sua aplicação mantenha o padrão de qualidade esperado antes de entrar em produção.
Os quatro pilares da arquitetura em Python
O primeiro pilar consiste no conjunto de dados de teste, responsável por estruturar cenários representativos e casos extremos. Em seguida, o executor envia as requisições às APIs dos modelos de maneira assíncrona para garantir alta velocidade.
Na sequência, o avaliador analisa as saídas utilizando regras determinísticas ou a abordagem de LLM-as-a-judge. Por fim, o agregador consolida os resultados em relatórios detalhados com estatísticas de custo e taxa de acerto.
Próximos passos na implementação prática
Integrar a avaliação de LLMs ao pipeline contínuo de integração e entrega (CI/CD) previne regressões indesejadas em atualizações de prompts. Essa prática eleva a robustez das soluções corporativas e protege sistemas contra alucinações críticas.
Fonte original: Leia mais na fonte