
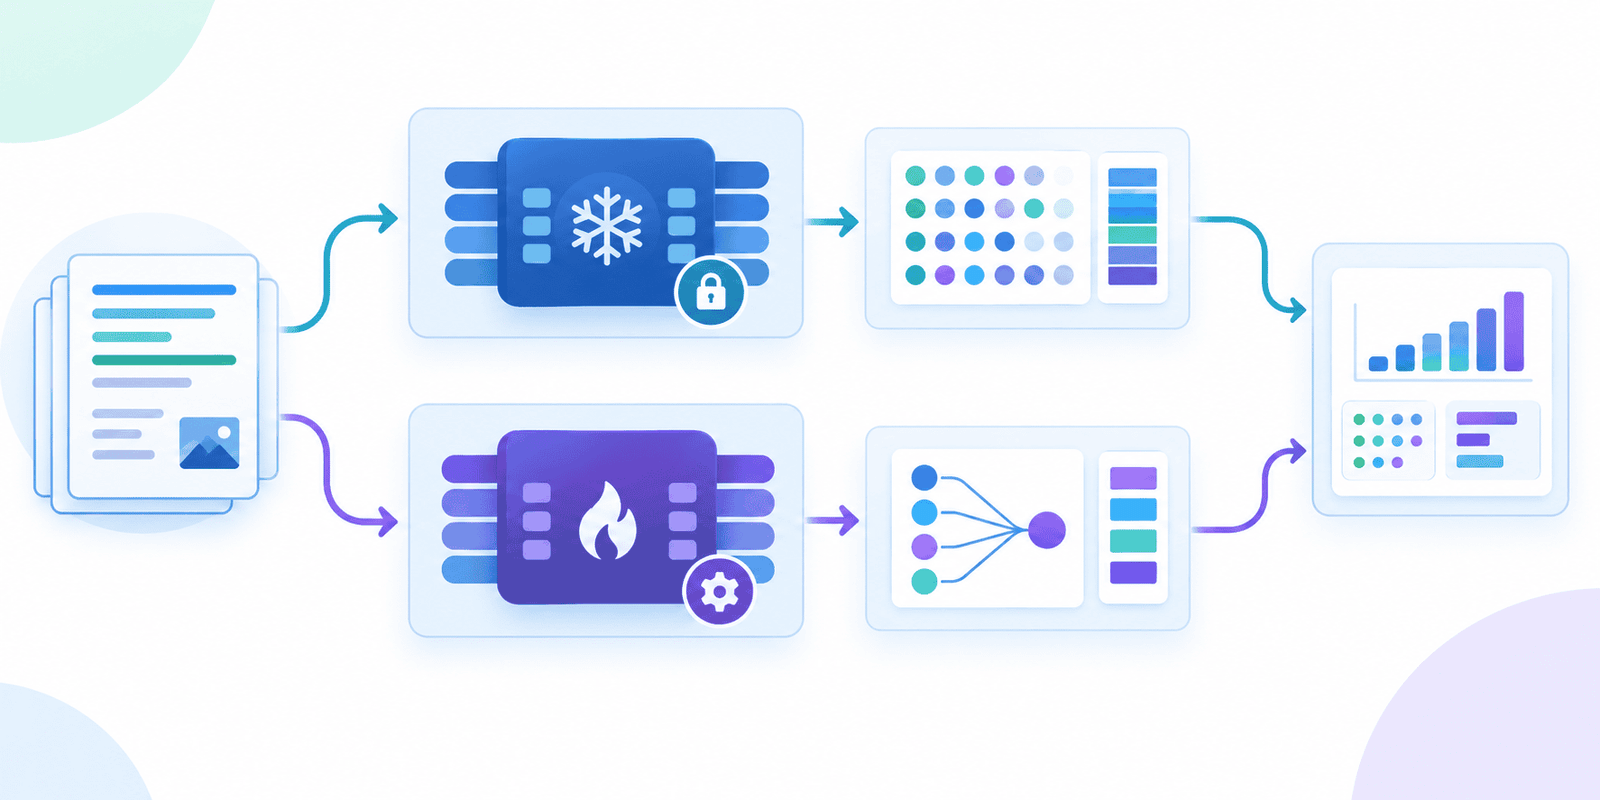

A escolha entre fine-tuning de LLMs e o uso de embeddings congelados depende diretamente do volume de dados, do custo computacional e da complexidade da tarefa a ser executada em projetos de IA.
Destaques Rápidos
- Técnicas como LoRA permitem adaptar pesos de LLMs com até 90% menos consumo de memória VRAM.
- Embeddings estáticos associados a Scikit-Learn reduzem custos ao dispensar treinamento contínuo de GPUs.
- Modelos ajustados apresentam ganhos expressivos quando o vocabulário do setor diverge da base pré-treinada.
Vantagens do Fine-Tuning de LLMs com LoRA
O fine-tuning de LLMs utilizando técnicas de adaptação de baixo posto (LoRA) viabiliza o ajuste de parâmetros específicos sem exigir treinamento completo da arquitetura base. Essa estratégia permite capturar padrões linguísticos complexos e nuances estilísticas que classificadores tradicionais não compreendem.
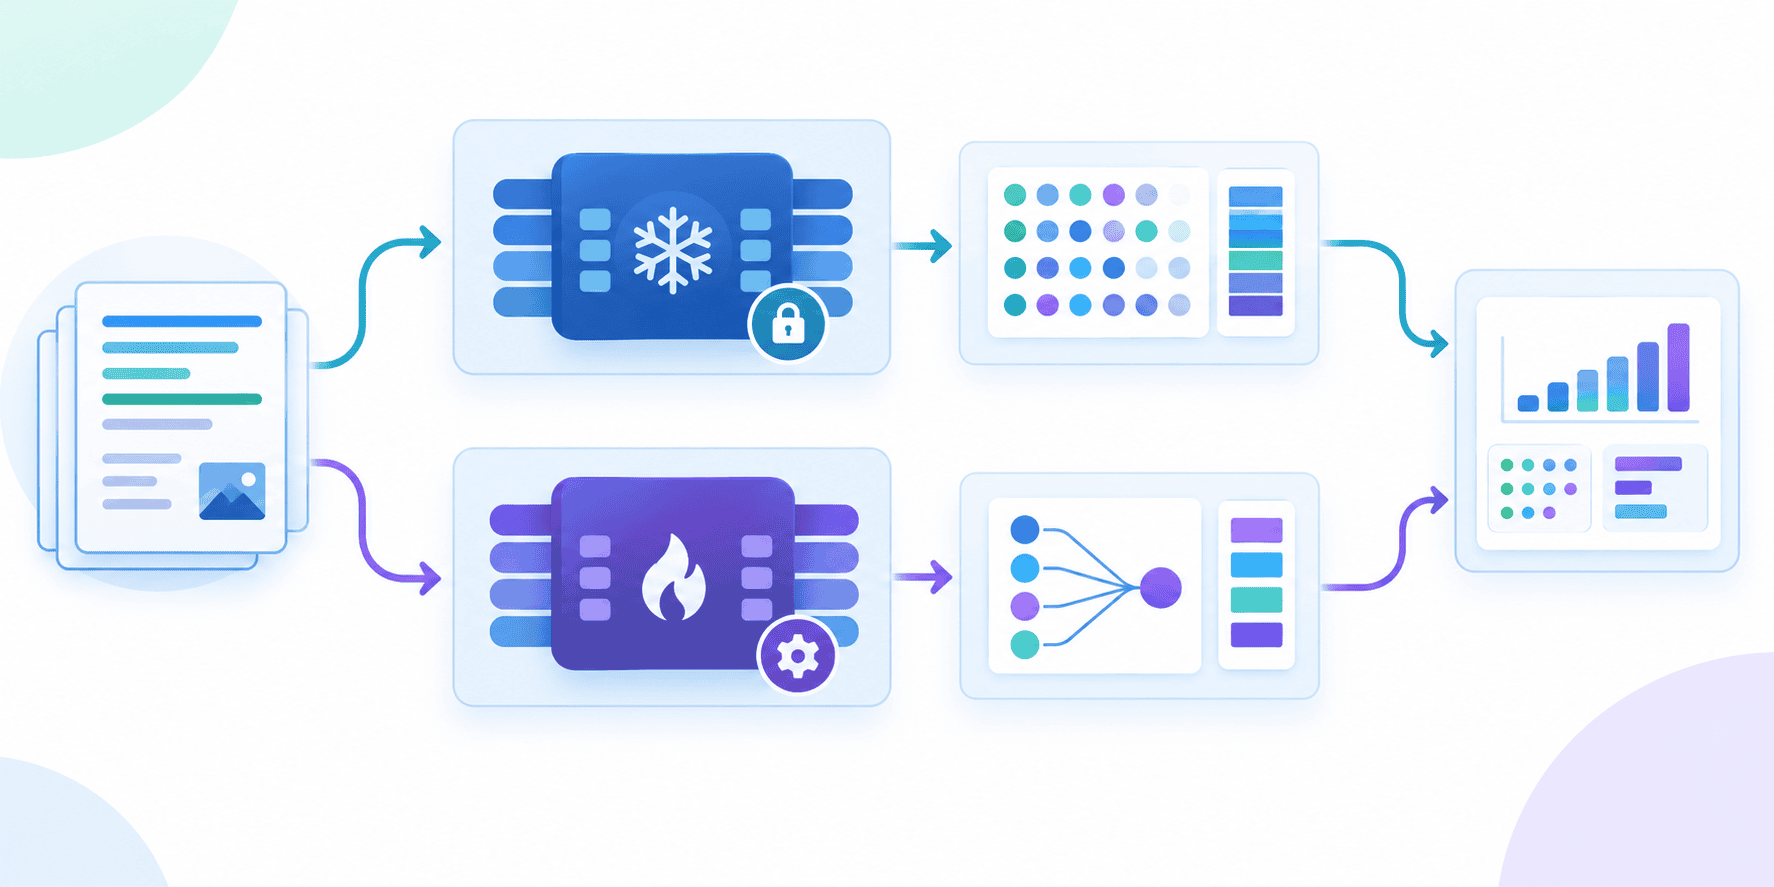
Ao congelar a maioria dos pesos e treinar apenas matrizes menores, os desenvolvedores conseguem resultados superiores em cenários altamente técnicos. Contudo, essa abordagem ainda demanda recursos de GPU dedicados para a etapa de inferência e ciclo de treinamento.
Uso de Embeddings Congelados na Prática
Por outro lado, extrair embeddings estáticos e aplicar algoritmos clássicos de machine learning, como regressão logística ou SVM via Scikit-Learn, é uma alternativa rápida e econômica. Esse método permite processar grandes volumes de texto com custos mínimos de infraestrutura computacional.
Essa abordagem brilha quando os dados do domínio já são bem representados pelo modelo de linguagem de base. Caso o vocabulário não possua jargões desconhecidos, a separabilidade linear dos vetores pode entregar acurácia similar ao ajuste fino.
Critérios para Escolher a Arquitetura
Para determinar o melhor caminho, equipes de engenharia devem avaliar a disponibilidade de dados rotulados e a latência aceitável na aplicação final. Projetos com orçamentos restritos ou escassez de dados podem começar com embeddings congelados e migrar gradualmente para o fine-tuning de LLMs caso o desempenho estagne.
Fonte original: Leia mais na fonte