
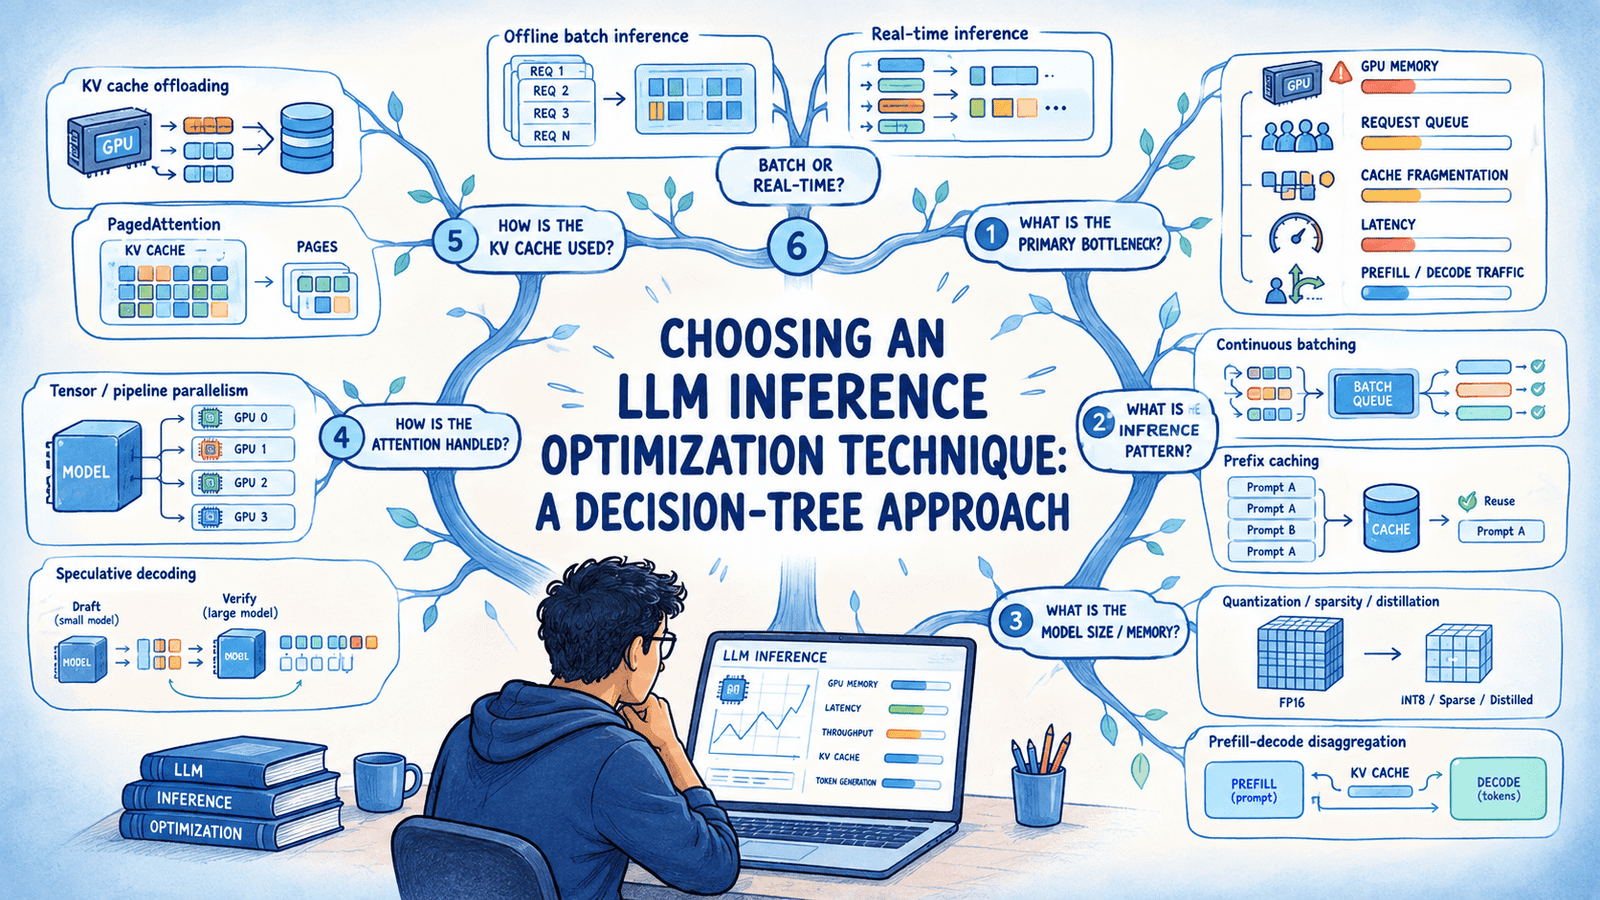

A otimização na inferência de LLMs exige identificar se o gargalo está na memória ou no processamento. Utilizar uma árvore de decisão ajuda desenvolvedores a escolherem a técnica correta para cada tipo de carga de trabalho.
Destaques Rápidos
- Diagnóstico preciso entre gargalos de banda de memória e capacidade computacional.
- Técnicas como quantização e pruning reduzem drasticamente o uso de VRAM.
- Uso de KV Cache e batching dinâmico para maximizar o rendimento dos servidores de IA.
Identificando os Gargalos na Inferência de LLMs
Para aplicar a técnica correta, o primeiro passo é entender onde o sistema encontra limitações. Em modelos de linguagem, as operações frequentemente ficam presas à velocidade da transferência de memória na GPU.
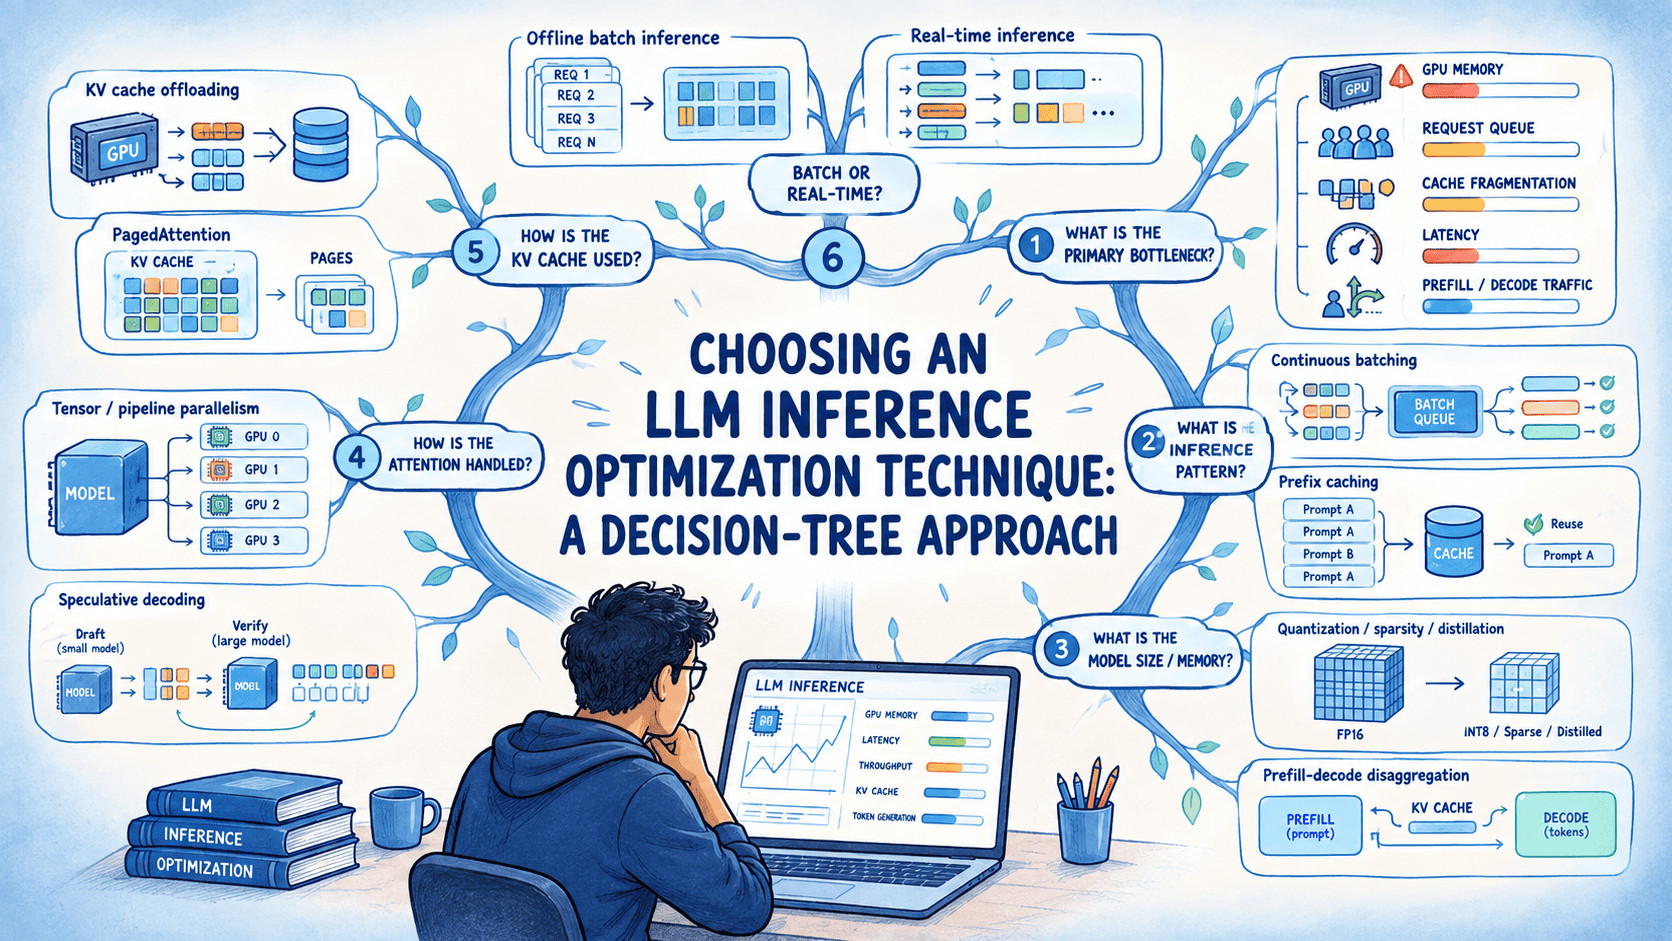
Quando a inferência de LLMs é limitada por memória, estratégias como a quantização de 8 ou 4 bits tornam-se essenciais. Isso reduz o tamanho do modelo e permite executar arquiteturas maiores em hardware mais acessível.
Estratégias de Árvore de Decisão para Engenharia de IA
Uma abordagem estruturada evita gastar recursos em soluções ineficazes para o problema atual. Se a latência por token for a prioridade absoluta, técnicas como a amostragem especulativa oferecem grandes ganhos.
Por outro lado, quando a meta é processar um volume massivo de requisições simultâneas, a implementação de batching contínuo e otimizações de atenção são as escolhas recomendadas.
Adoções corretas de arquitetura garantem que empresas reduzam custos operacionais mantendo a alta performance das aplicações baseadas em inteligência artificial.
Fonte original: Leia mais na fonte