
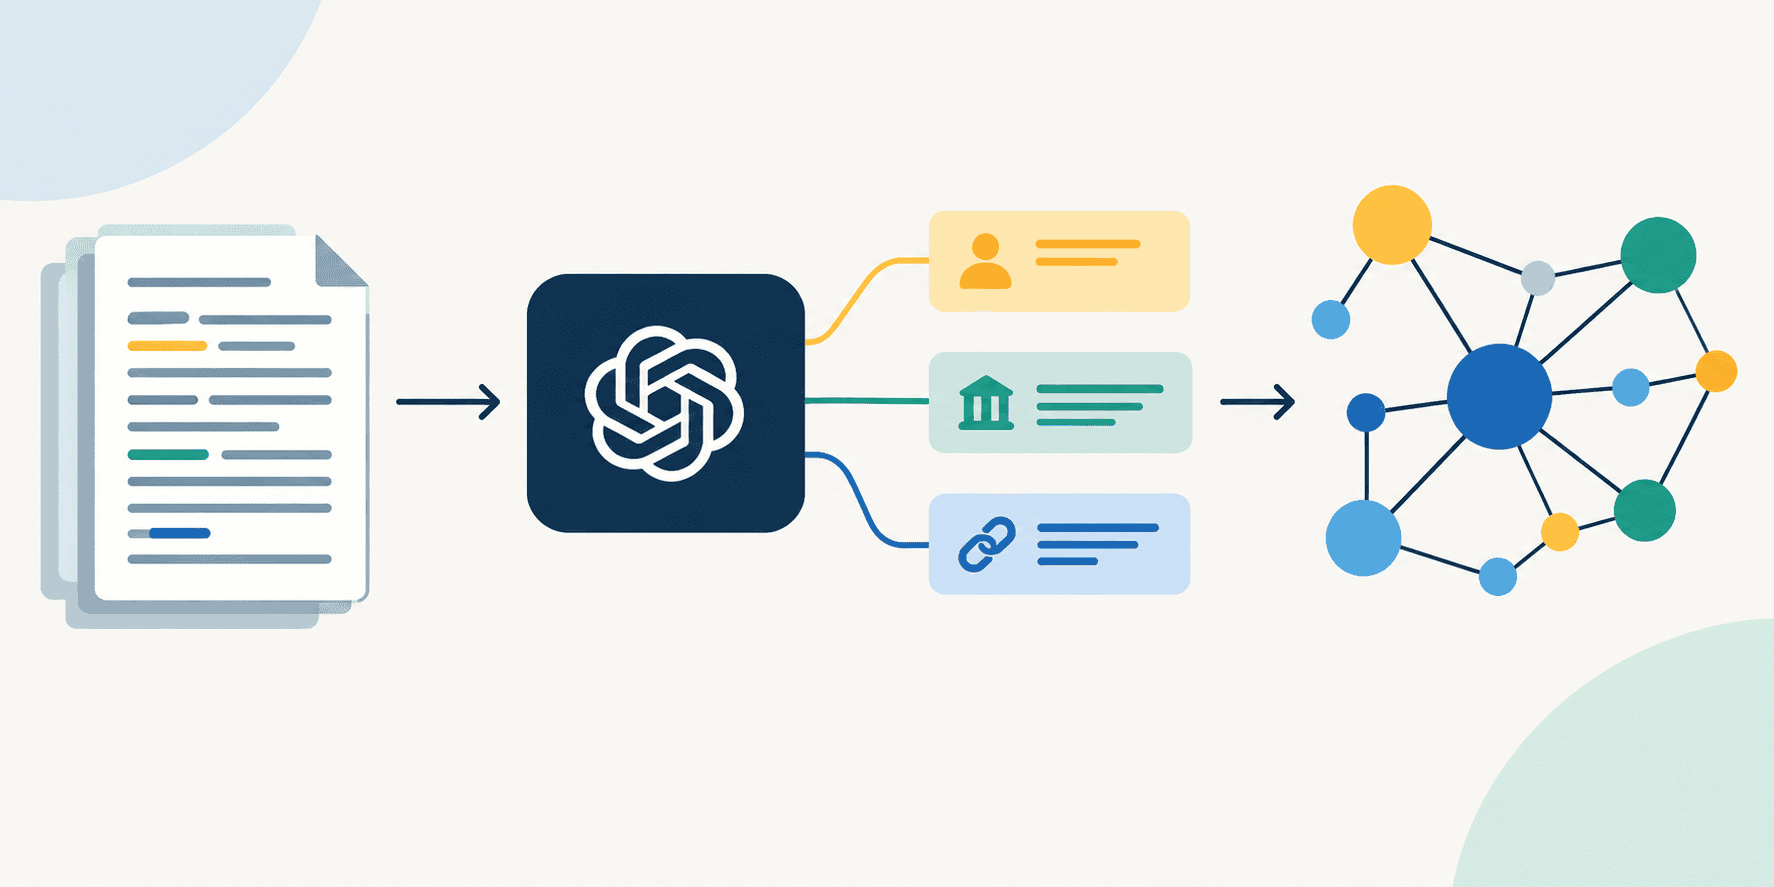

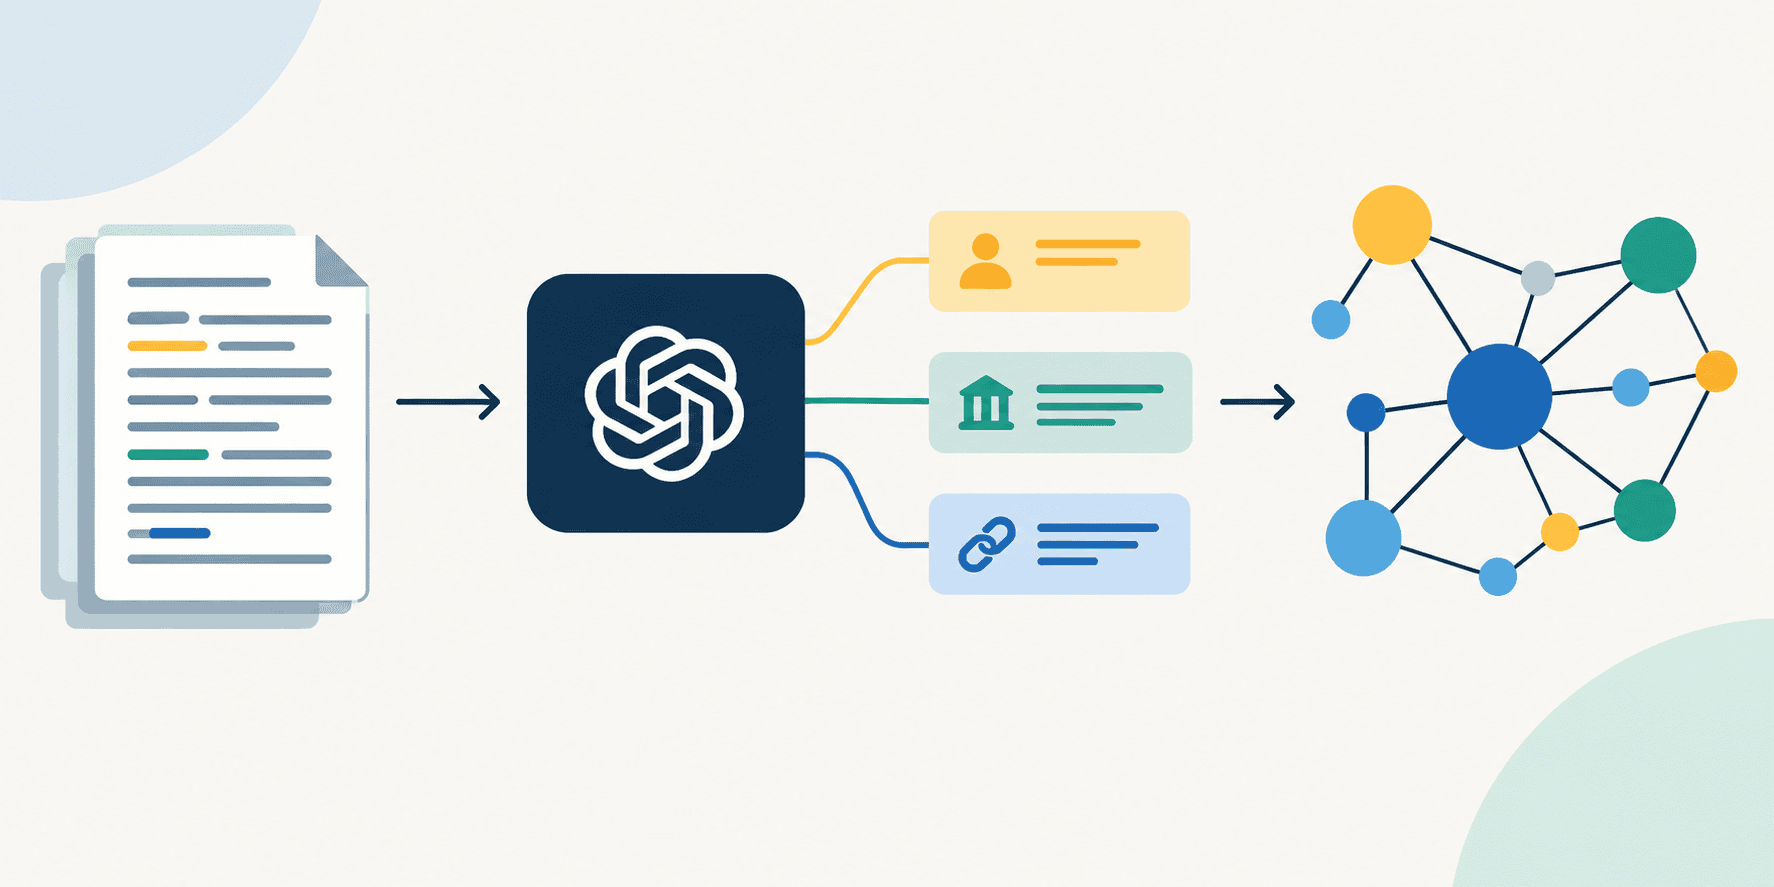
LLMs podem automatizar a extração de entidades e triplas de textos não estruturados, revolucionando a forma como grafos de conhecimento são populados e transformando dados brutos em informação estruturada para diversas aplicações de Inteligência Artificial.
Destaques Rápidos
- Modelos de Linguagem Grandes (LLMs) automatizam a extração de informações.
- Converte texto não estruturado em entidades e triplas (quads SPOC) para KGs.
- Otimiza a criação e atualização de grafos de conhecimento com alta eficiência.
A capacidade de transformar dados textuais sem formatação em um formato estruturado é um desafio complexo na área de Inteligência Artificial. Tradicionalmente, essa tarefa exigia regras complexas e muito trabalho manual, limitando a escalabilidade e a agilidade dos projetos.
No entanto, a ascensão dos LLMs (Modelos de Linguagem Grandes) está mudando esse cenário drasticamente. Essas ferramentas poderosas conseguem compreender o contexto e a semântica do texto, permitindo uma extração de dados muito mais sofisticada e automatizada.
O Papel dos LLMs na População de Grafos de Conhecimento
Grafos de conhecimento (KGs) são estruturas de dados que representam informações de forma interconectada, usando entidades e seus relacionamentos. Eles são cruciais para sistemas de recomendação, motores de busca e IA conversacional, oferecendo uma representação rica e semântica do mundo.
Com os LLMs, é possível identificar não apenas as entidades (pessoas, locais, organizações) em um texto, mas também as relações entre elas, formando triplas (sujeito-predicado-objeto). Isso permite preencher um grafo de conhecimento de maneira eficiente e em larga escala, algo antes inviável.
Extração de Entidades e Triplas: A Base para KGs
O processo envolve a leitura de um texto por um LLM, que então é instruído a identificar e categorizar as entidades presentes. Em seguida, o modelo estabelece as conexões lógicas entre essas entidades, gerando as triplas que formam a espinha dorsal de qualquer grafo de conhecimento.
Essa abordagem com LLMs não só acelera a criação de KGs, mas também melhora a qualidade dos dados extraídos. A flexibilidade dos modelos permite adaptar-se a diferentes domínios e tipos de texto, tornando a tarefa de população de grafos de conhecimento mais acessível e eficaz.
Fonte original: Leia mais na fonte