
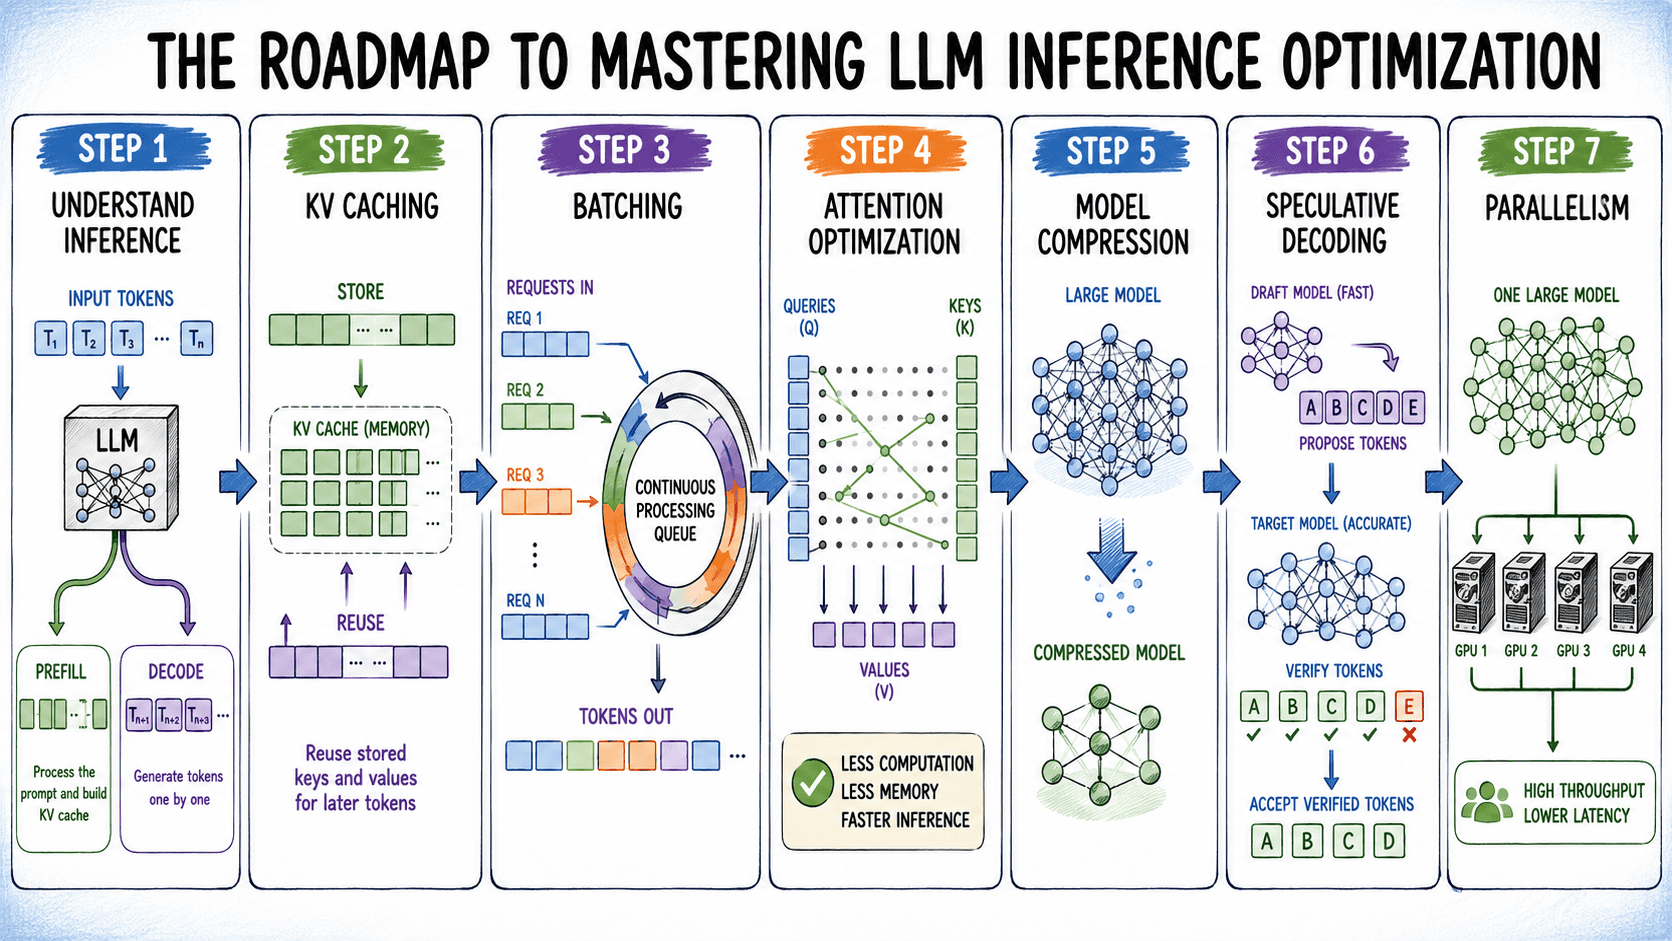

A otimização da inferência de LLMs é crucial para acelerar modelos de linguagem, reduzir custos operacionais e aumentar a confiabilidade de suas aplicações. Novas técnicas permitem que esses modelos rodem de forma mais eficiente, tornando a IA generativa acessível e escalável para diversas empresas e desenvolvedores.
Destaques Rápidos
- Acelera o tempo de resposta de modelos de linguagem em até 10x.
- Reduz os custos de infraestrutura e computação em até 50%.
- Melhora a estabilidade e a capacidade de processamento de grandes volumes de requisições.
A inferência de Large Language Models (LLMs) representa a fase onde o modelo processa uma entrada para gerar uma saída. Este processo pode ser computacionalmente intensivo, exigindo recursos significativos. Por isso, a busca por métodos de otimização se tornou uma prioridade para a indústria de IA.
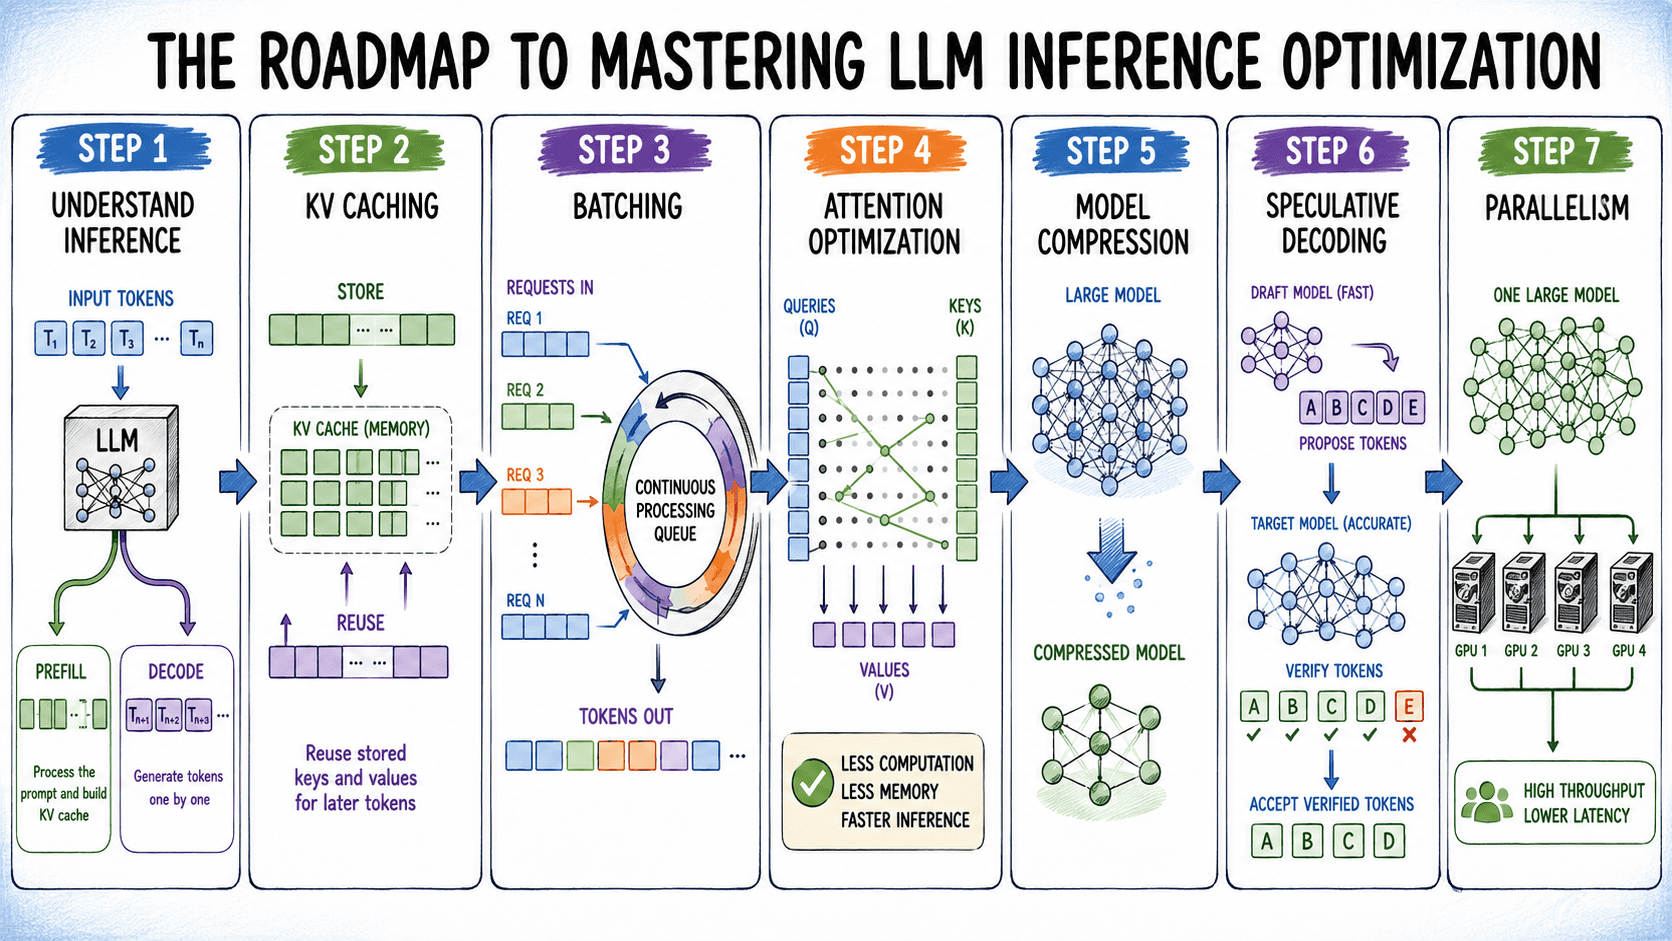
Técnicas como a quantização e o podamento (pruning) são fundamentais nesse cenário. A quantização reduz a precisão dos pesos do modelo, diminuindo o tamanho e a demanda por memória, enquanto o podamento remove conexões menos relevantes. Ambas visam manter a performance com menor custo.
Otimização de LLM para Desempenho
Outras estratégias incluem a compilação de modelos para hardware específico e a utilização de inferência em lote (batching). A compilação adapta o modelo para aproveitar ao máximo a arquitetura da GPU, por exemplo. Já o batching agrupa múltiplas requisições, processando-as simultaneamente para otimizar o uso dos recursos.
A escolha da arquitetura do modelo também influencia diretamente a eficiência. Modelos mais leves e projetados para inferência rápida podem superar modelos maiores em cenários específicos. É crucial balancear a qualidade da saída com os requisitos de velocidade e custo.
A otimização contínua da inferência de LLM é um campo em rápida evolução. Adotar uma abordagem sistemática, testando diferentes técnicas e monitorando o desempenho, é essencial. Isso garante que as aplicações de IA generativa permaneçam competitivas e economicamente viáveis.
Fonte original: Leia mais na fonte