
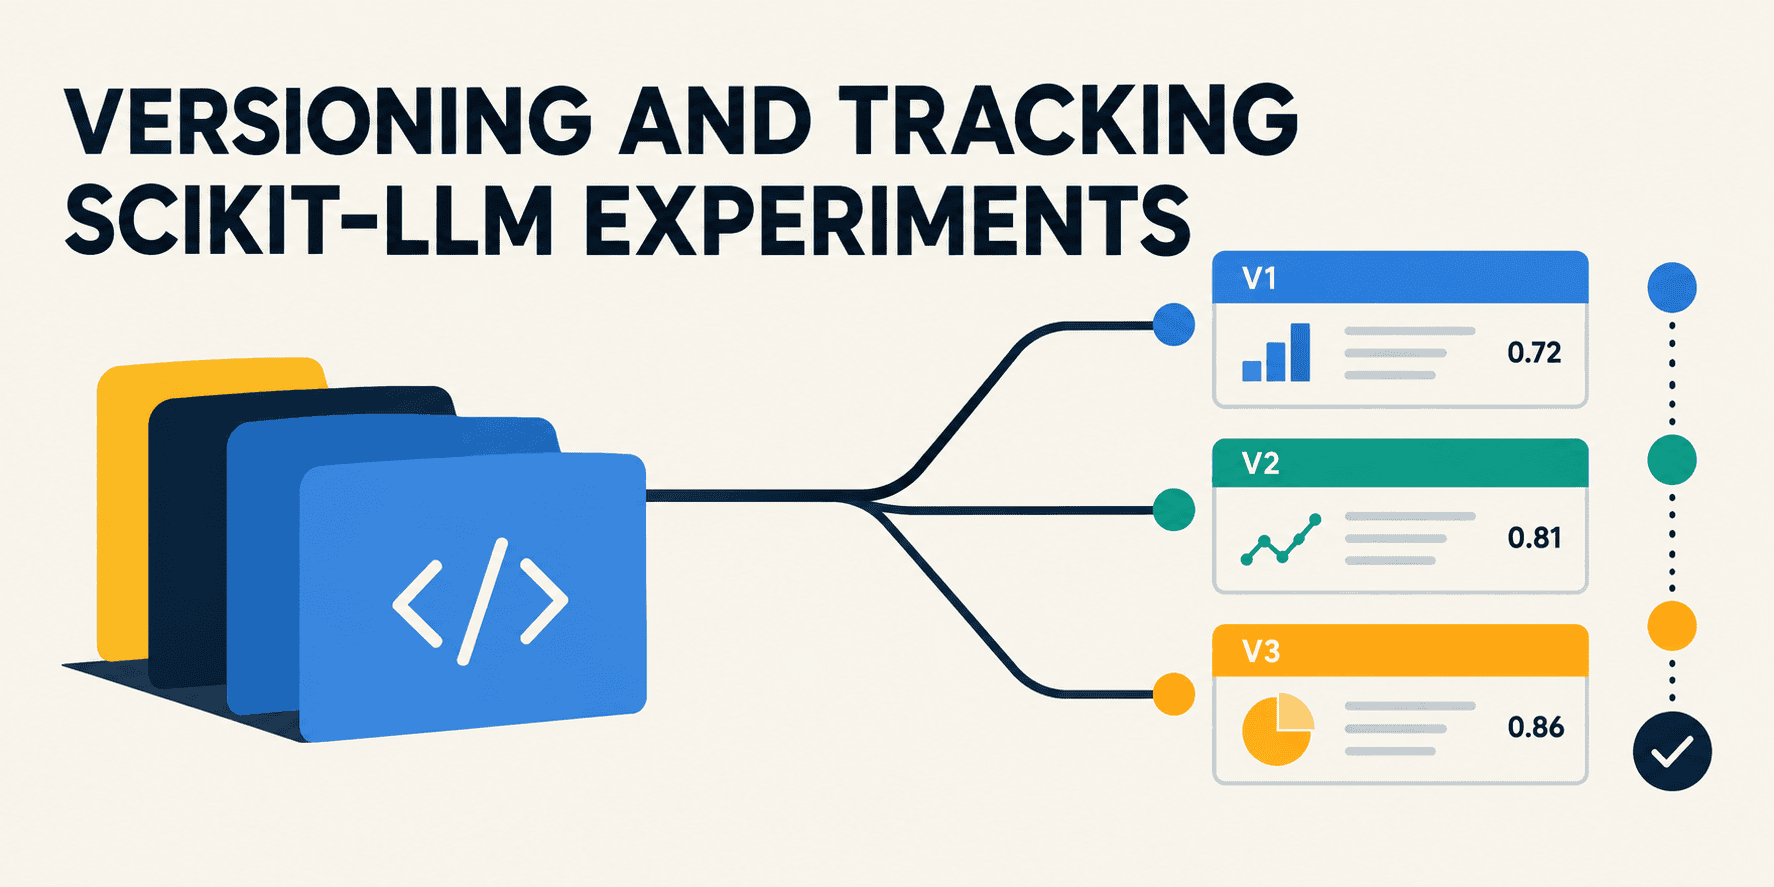

A integração da biblioteca Scikit-LLM com o MLflow permite rastrear, comparar e gerenciar pipelines de aprendizado de máquina baseados em modelos de linguagem avançados com total eficiência.
Destaques Rápidos
- Integração de modelos de linguagem em pipelines scikit-learn tradicionais.
- Rastreamento automatizado de métricas e hiperparâmetros em experimentos com MLflow.
- Registro e versionamento simplificados de modelos preditivos baseados em LLMs.
Como Funciona o Rastreamento com Scikit-LLM
O desenvolvimento de aplicações modernas de ciência de dados exige a combinação de algoritmos clássicos de aprendizado com a capacidade de processamento de linguagem natural dos grandes modelos de linguagem. A biblioteca Scikit-LLM facilita esse processo ao encapsular chamadas de API em estimadores compatíveis com o ecossistema scikit-learn.
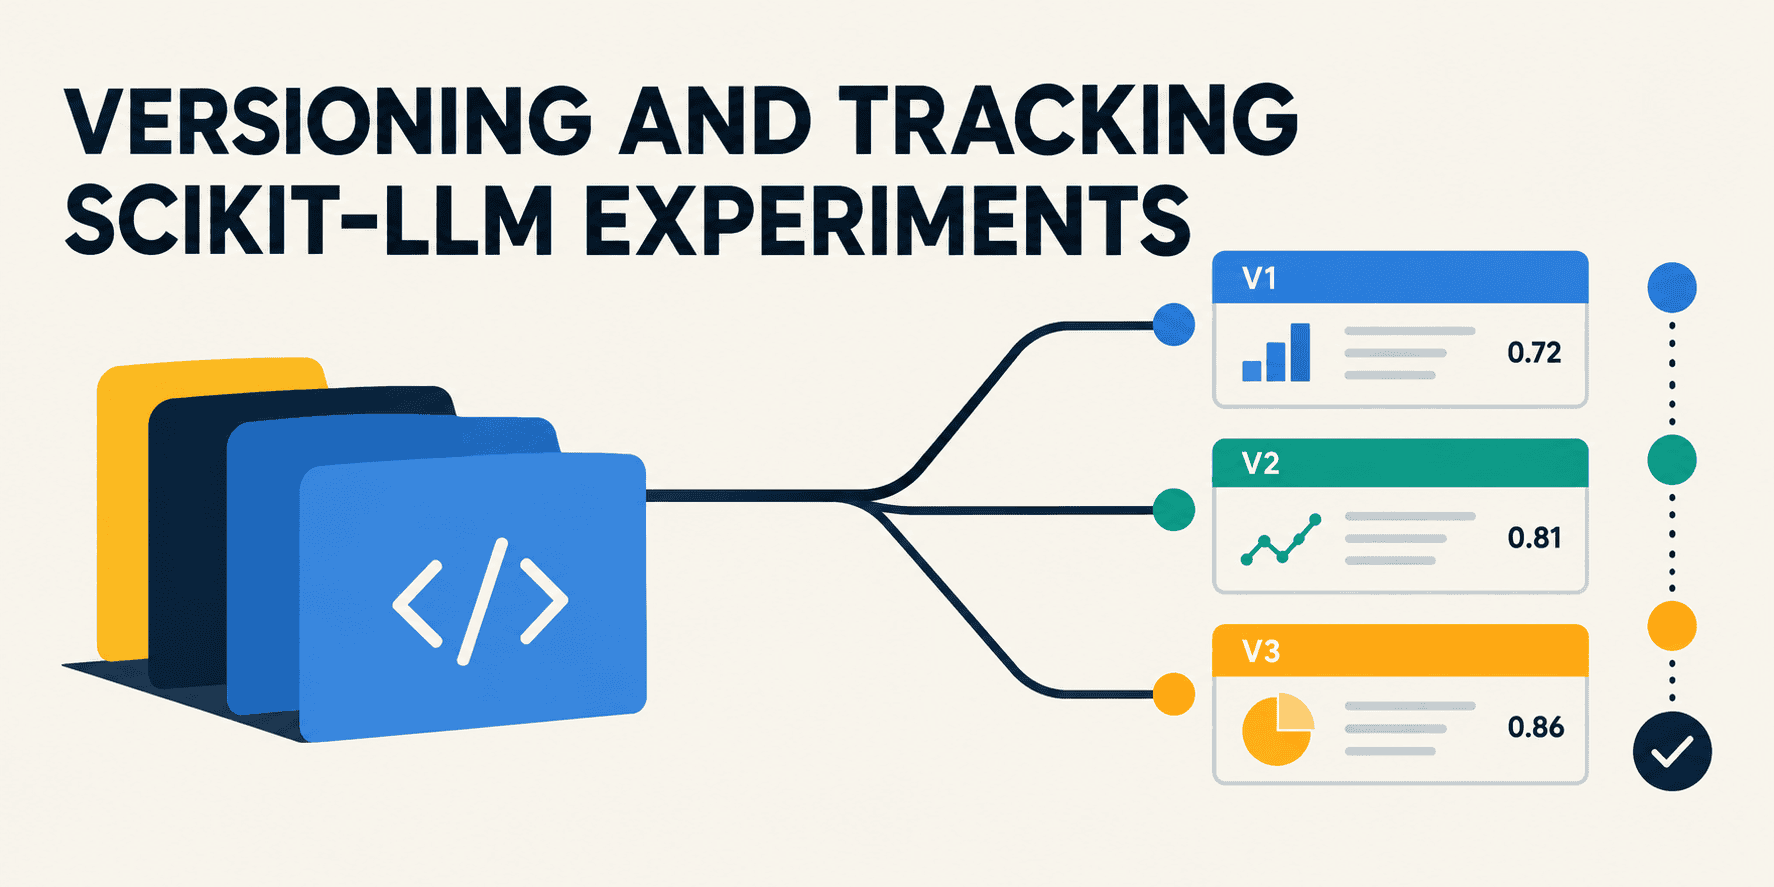
Ao integrar o MLflow nesse fluxo de trabalho, os cientistas de dados conseguem registrar automaticamente parâmetros, métricas de avaliação e artefatos gerados durante os testes. Isso garante a reprodutibilidade dos experimentos e a transparência no desenvolvimento de soluções de inteligência artificial.
Benefícios do Versionamento de Pipelines de IA
Com a rápida evolução das arquiteturas de IA, manter o controle sobre o desempenho de cada versão de modelo torna-se fundamental para ambientes de produção. O versionamento adequado evita regressões no código e garante que as melhores configurações sejam implantadas com segurança.
Além disso, o ciclo de vida dos modelos torna-se totalmente auditável, simplificando a colaboração entre equipes de engenharia de machine learning. Dessa forma, as organizações maximizam a eficiência no uso de modelos de linguagem em escala comercial.
Fonte original: Leia mais na fonte