
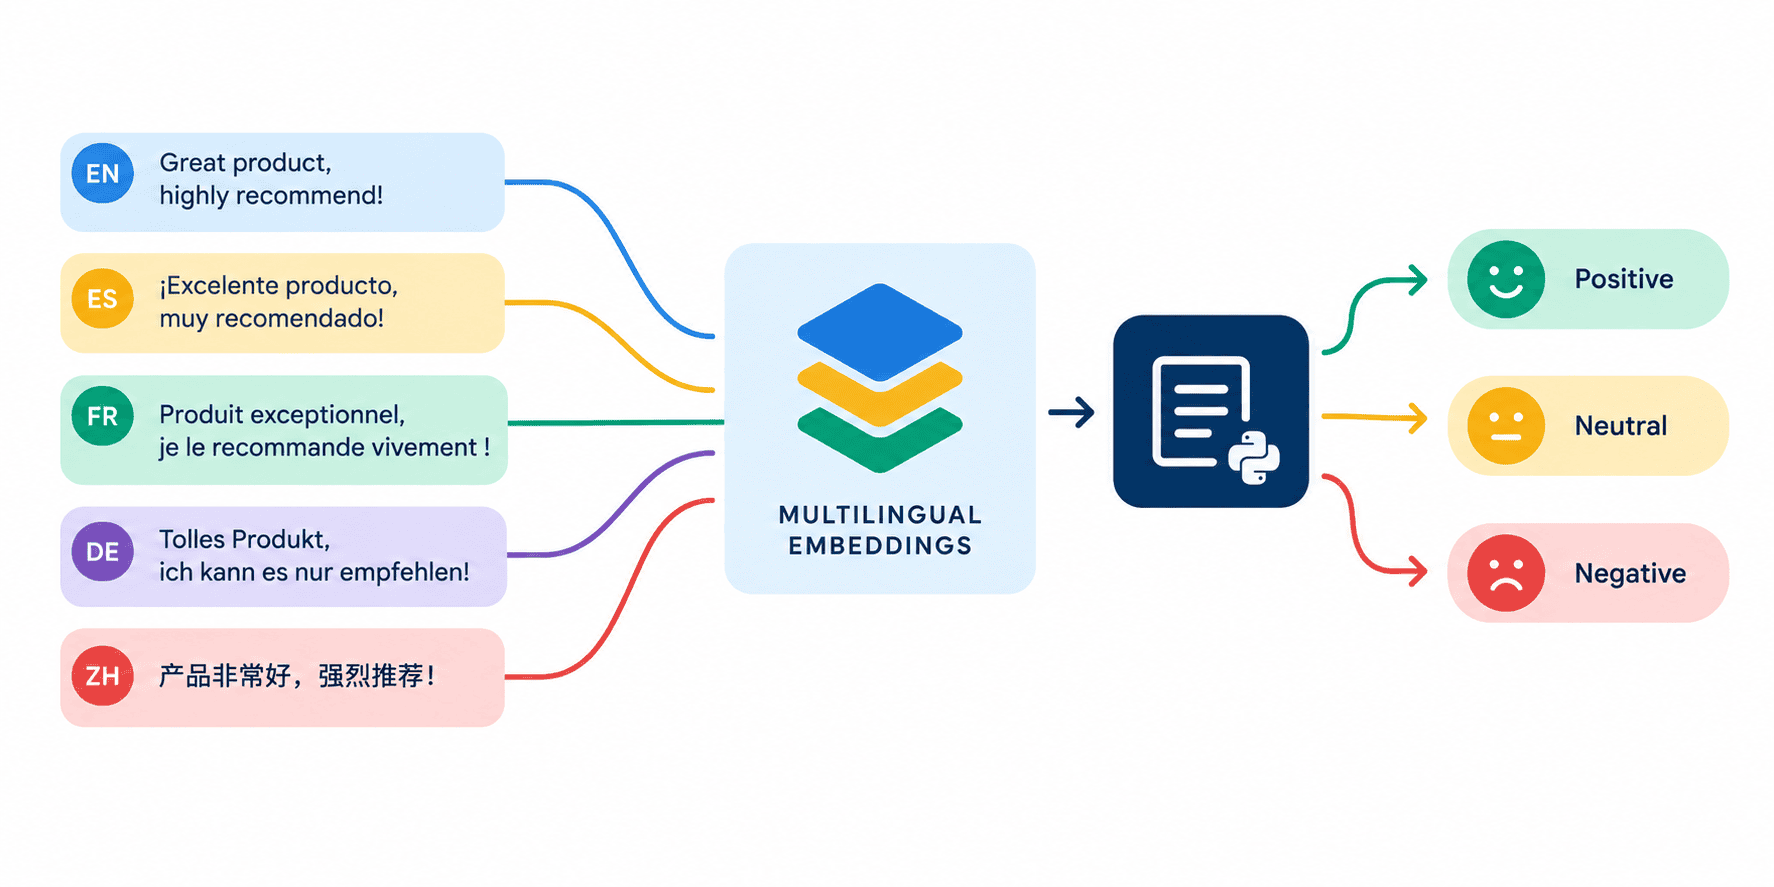

O Scikit-LLM possibilita criar pipelines de classificação de texto multilíngue integrando modelos de linguagem avançados ao Scikit-learn sem realizar treinamento.
Destaques Rápidos
- Integração direta entre modelos de linguagem e a biblioteca Scikit-learn.
- Classificação em diversos idiomas sem etapas de ajuste fino (fine-tuning).
- Redução do tempo e custo no desenvolvimento de fluxos de Machine Learning.
Desenvolvedores e cientistas de dados agora podem aplicar o Scikit-LLM para processar textos em múltiplos idiomas de forma simplificada. Essa abordagem combina a eficiência de embeddings multilíngues com a estrutura tradicional de aprendizado de máquina em Python.
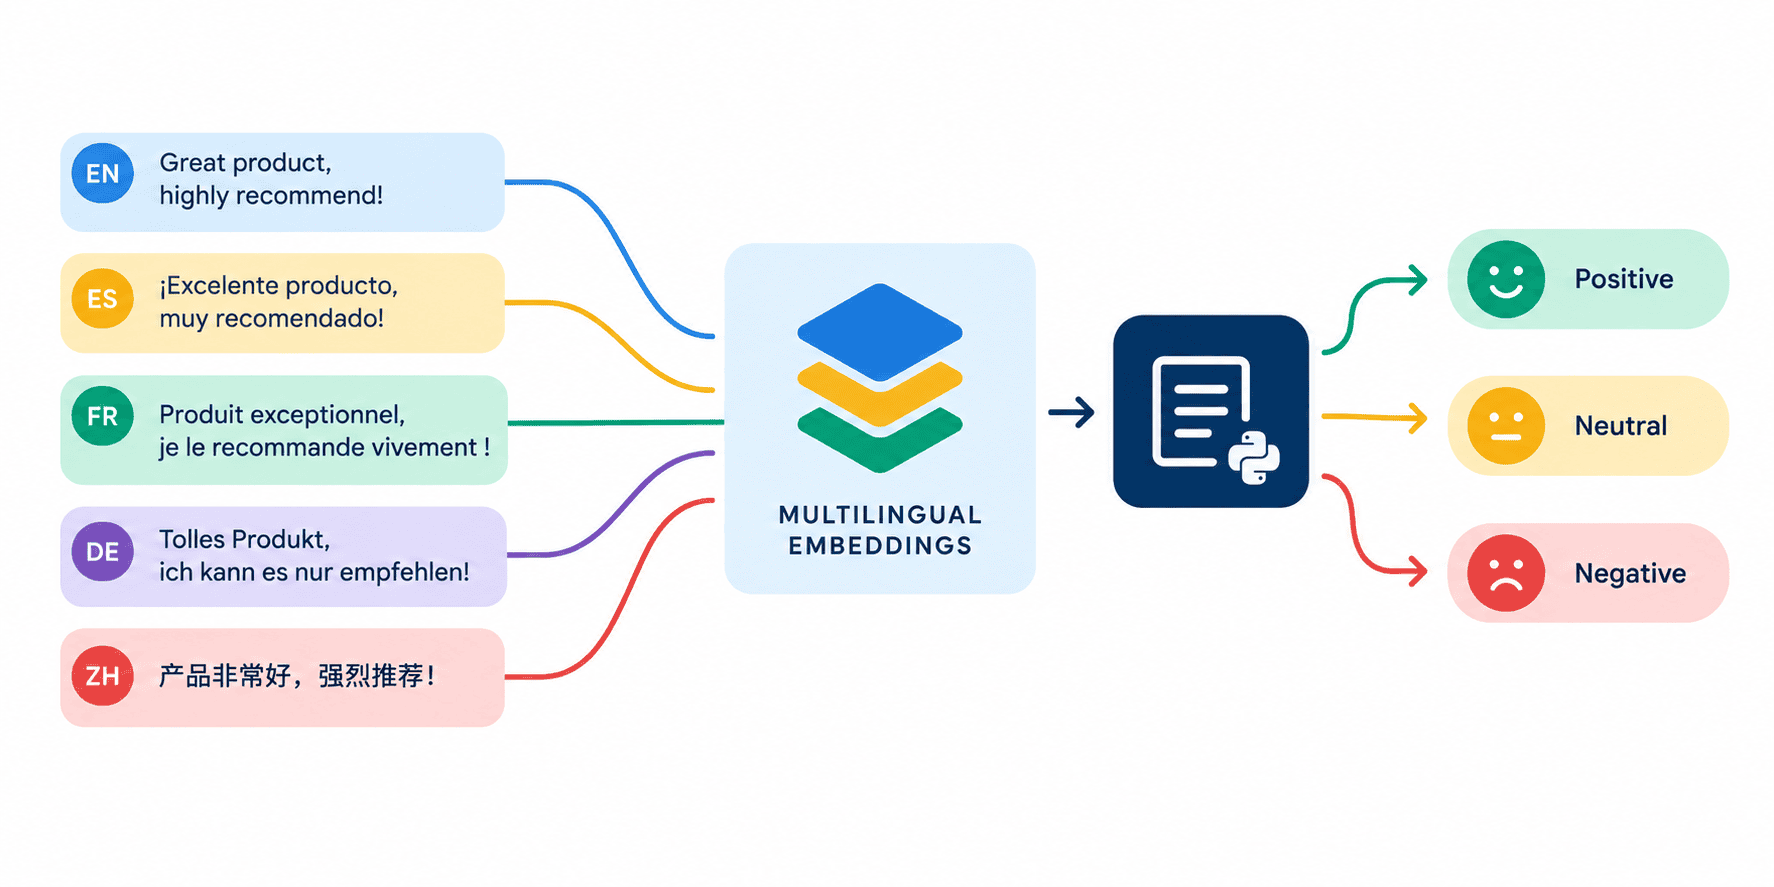
Como funciona o Scikit-LLM no ecossistema de IA
A grande vantagem do uso do Scikit-LLM é eliminar a necessidade de treinar redes neurais pesadas do zero. Ao converter documentos em vetores semânticos de alta dimensão, o sistema preserva o contexto do texto independente do idioma nativo.
Além disso, essa integração permite reaproveitar estimadores familiares do Scikit-learn para tarefas complexas de PNL. Dessa forma, reduz-se drasticamente a complexidade do código e a demanda por infraestrutura cara.
Impacto na eficiência de projetos de dados
Organizações que lidam com atendimento internacional ou análise de grandes volumes de texto se beneficiam diretamente desse fluxo. A tecnologia entrega alta precisão na categorização de informações mesmo em cenários de pouca disponibilidade de dados.
Fonte original: Leia mais na fonte