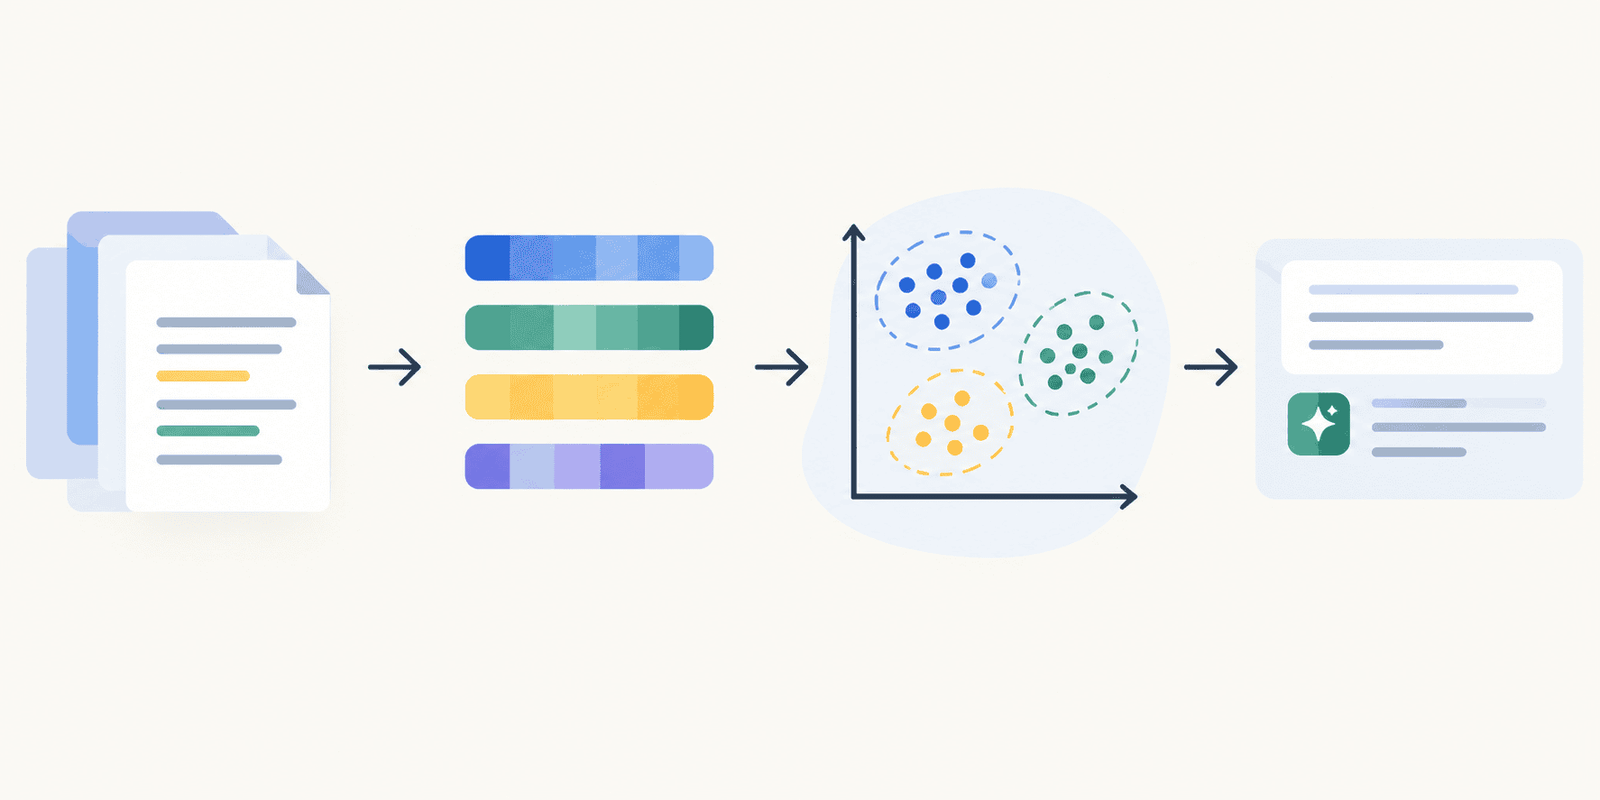

Um novo método para construir um pipeline RAG leve utiliza a biblioteca scikit-learn para busca vetorial junto a modelos de IA open-source, otimizando a recuperação de dados em sistemas baseados em inteligência artificial.
Destaques Rápidos
- Uso da biblioteca clássica scikit-learn para busca por vizinhos mais próximos.
- Integração direta com modelos abertos de embeddings para geração de vetores.
- Arquitetura simplificada para pipelines RAG sem dependência de bancos vetoriais complexos.
O Que É um Pipeline RAG Simplificado?
A técnica de Recuperação Aumentada por Geração melhora as respostas fornecidas por grandes modelos de linguagem. Ao integrar bases externas de conhecimento, o modelo entrega respostas mais precisas e contextualizadas.
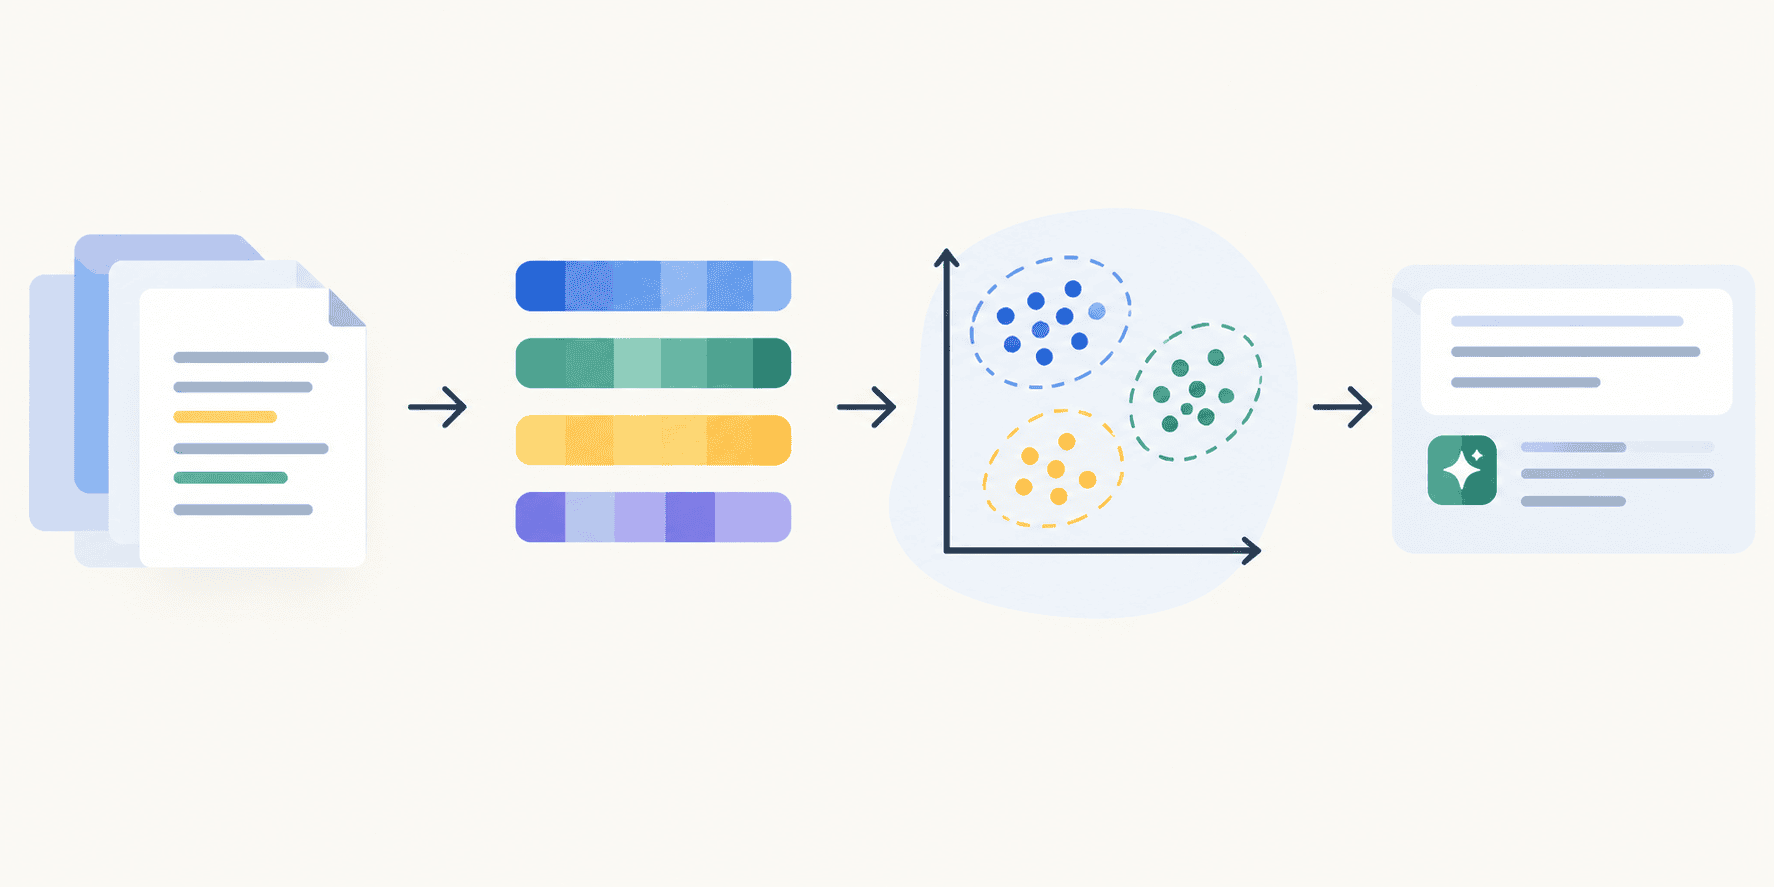
Tradicionalmente, a implementação de um pipeline RAG exige bancos de dados vetoriais dedicados. No entanto, o uso do scikit-learn surge como uma alternativa viável e extremamente leve para pequenos e médios projetos.
Como Funciona a Busca Vetorial no Scikit-learn
A biblioteca scikit-learn permite criar índices de busca rapidamente através de algoritmos de vizinhos mais próximos. Esses algoritmos calculam a similaridade entre o texto digitado pelo usuário e os documentos armazenados.
Combinando essa estrutura com embeddings gerados por modelos abertos, os desenvolvedores reduzem significativamente a complexidade da infraestrutura. Essa abordagem simplifica o código e facilita a manutenção do sistema no longo prazo.
Benefícios para Desenvolvedores de IA
Adotar um pipeline RAG simplificado reduz custos operacionais de servidor e acelera a fase de testes. A solução é ideal para protótipos rápidos e aplicações corporativas que demandam baixa latência.
Além disso, o controle total sobre a recuperação dos vetores garante maior flexibilidade para ajustar hiperparâmetros e melhorar a precisão das buscas.
Fonte original: Leia mais na fonte